Pipeline computationnel
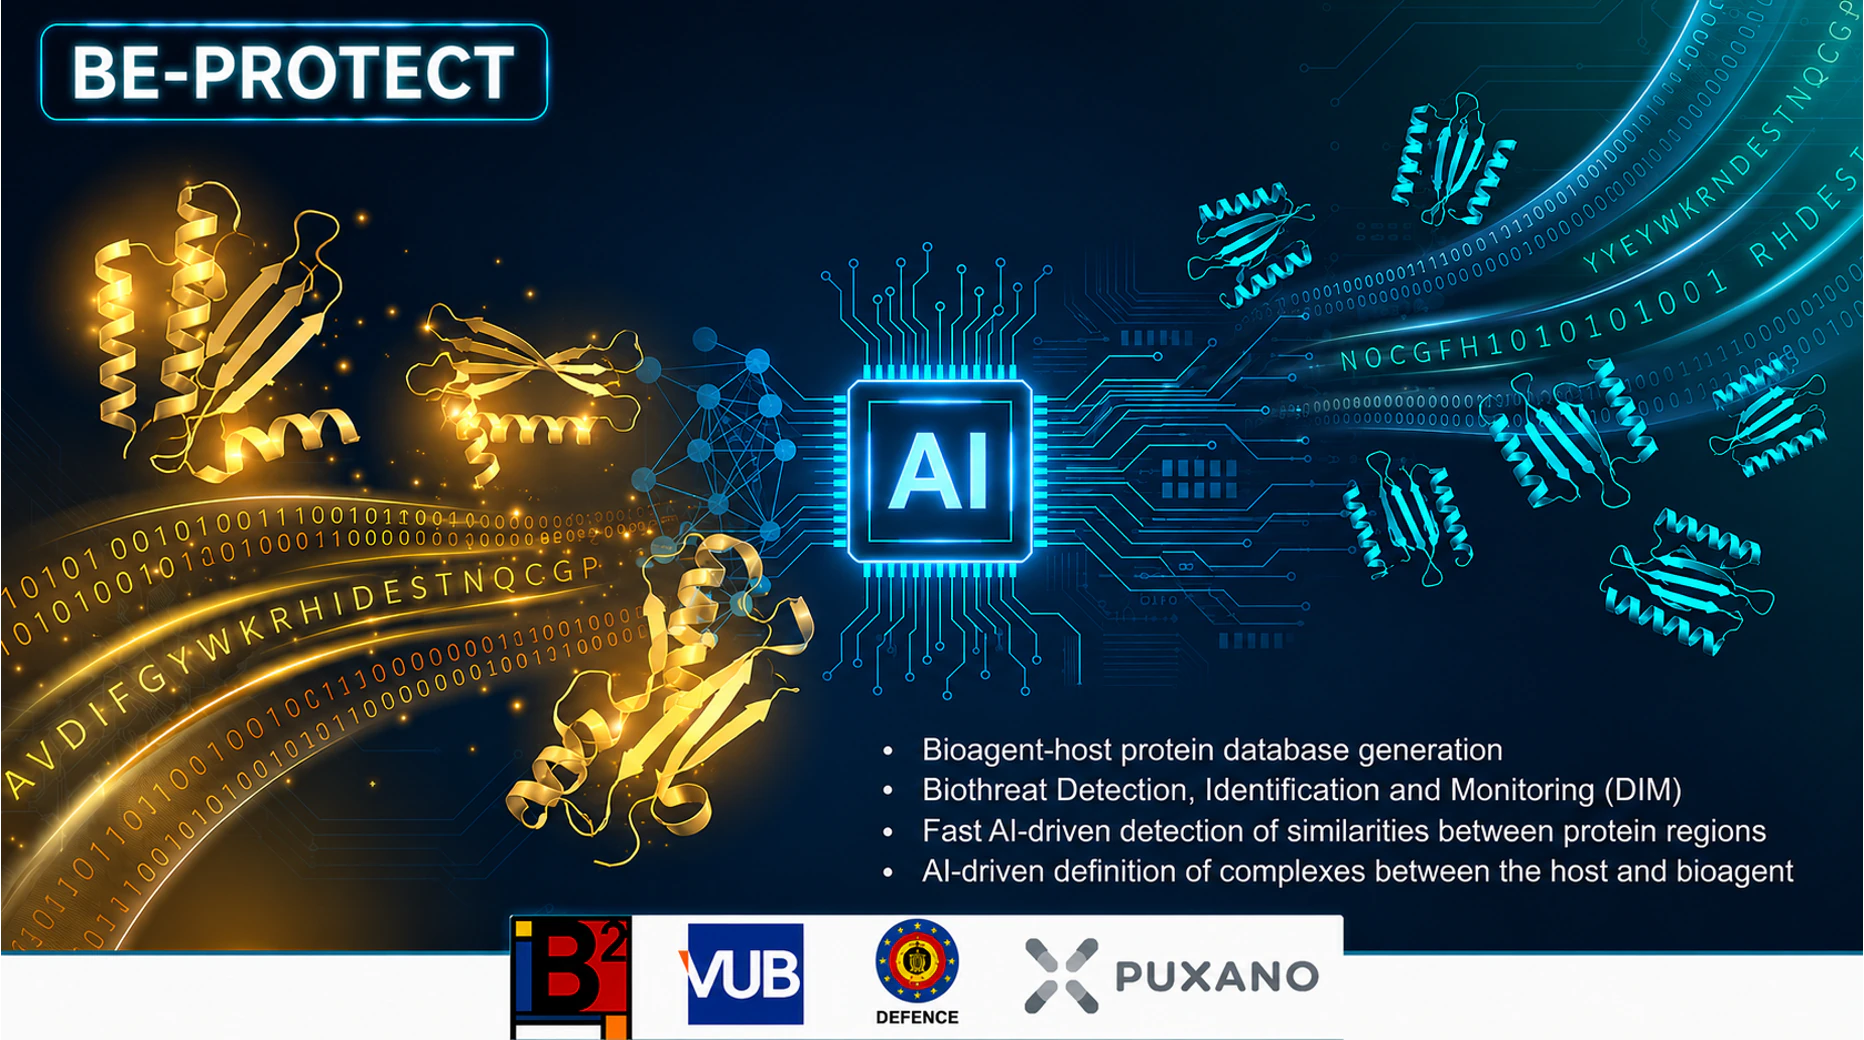
BE-PROTECT met au point des mesures de biodéfense « made in Belgium » renforcées, destinées à optimiser l'évaluation, la prévention et la préparation, ainsi que la réponse et le rétablissement en cas d'incident biologique. Pour ce faire, le projet formule un pipeline computationnel de caractérisation protéique in silico approfondie, qui interprète les informations expérimentales de niveau génomique relatives aux bioagents, qu'ils soient d'origine naturelle ou disséminés avec une intention malveillante.
La nouveauté déterminante de cette approche est qu'elle prend également en compte les régions flexibles non repliées des protéines. De nombreux mécanismes pathogènes s'appuient sur ces régions flexibles pour infecter les cellules hôtes et interférer avec elles, mais elles sont le plus souvent ignorées en raison de la difficulté à les caractériser et à les interpréter.
BE-PROTECT atteint cet objectif en combinant des données accessibles au public, des méthodes existantes et un usage responsable de l'IA afin d'identifier la fonction et les cibles probables des protéines de bioagents, de les comparer aux protéines de pathogènes annotées ainsi qu'aux protéines de l'hôte, puis d'identifier les interactions protéiques probables et les médicaments susceptibles de perturber le bioagent, par repositionnement de médicaments et par mini-binders conçus par IA.
Le pipeline computationnel se veut entièrement à double usage, avec un composant public pour les mesures générales de santé publique et un composant privé pour la biodéfense relative aux bioagents sensibles, où les données d'entrée du pipeline et ses résultats peuvent être traités de manière sécurisée, selon un fonctionnement pleinement parallèle.